De AI-markt verandert sneller dan de gemiddelde softwarearchitectuur prettig vindt.
Een model dat vandaag de logische keuze is, kan over zes maanden ingehaald zijn. Een provider introduceert een nieuwe API. Een klant wil gegevens binnen Europa verwerken. Een open-weight model wordt ineens goed genoeg voor een taak waarvoor eerder een groot commercieel model nodig was.
Als je applicatie volledig is opgebouwd rond één specifieke AI-provider, wordt iedere verandering duur.
Daarom hanteren we bij nieuwe AI-toepassingen steeds vaker één uitgangspunt:
de applicatie is van ons. Het model is een verwisselbaar onderdeel.
Dat klinkt simpeler dan het technisch is.
Een AI-integratie is inmiddels veel meer dan één API-call
Bij de eerste generatie AI-functionaliteit kon je nog redelijk eenvoudig een prompt naar een model sturen en de tekst teruggeven aan de gebruiker.
Moderne toepassingen doen veel meer.
Ze gebruiken documenten en vector search. Ze roepen tools aan. Ze bewaren gesprekscontext. Ze streamen tussenresultaten. Ze voeren meerdere stappen achter elkaar uit. Ze moeten omgaan met time-outs, limieten en fouten. Soms duurt een proces langer dan één webrequest en moet het later verder kunnen gaan.
Daarbovenop verschillen providers in de manier waarop ze dit aanbieden.
Als al die details rechtstreeks door de businesslogica heen lopen, ontstaat vendor lock-in bijna vanzelf.
Daarom bouwen we een laag ertussen
We werken aan een provider-onafhankelijke orchestratielaag die de applicatie losser koppelt van het onderliggende model.
De applicatie beschrijft bijvoorbeeld dat er een antwoord nodig is op basis van bepaalde bronnen, dat een tool gebruikt mag worden en dat het resultaat in een bepaald formaat terug moet komen.
De orchestratielaag bepaalt vervolgens hoe dat bij de gekozen provider wordt uitgevoerd.
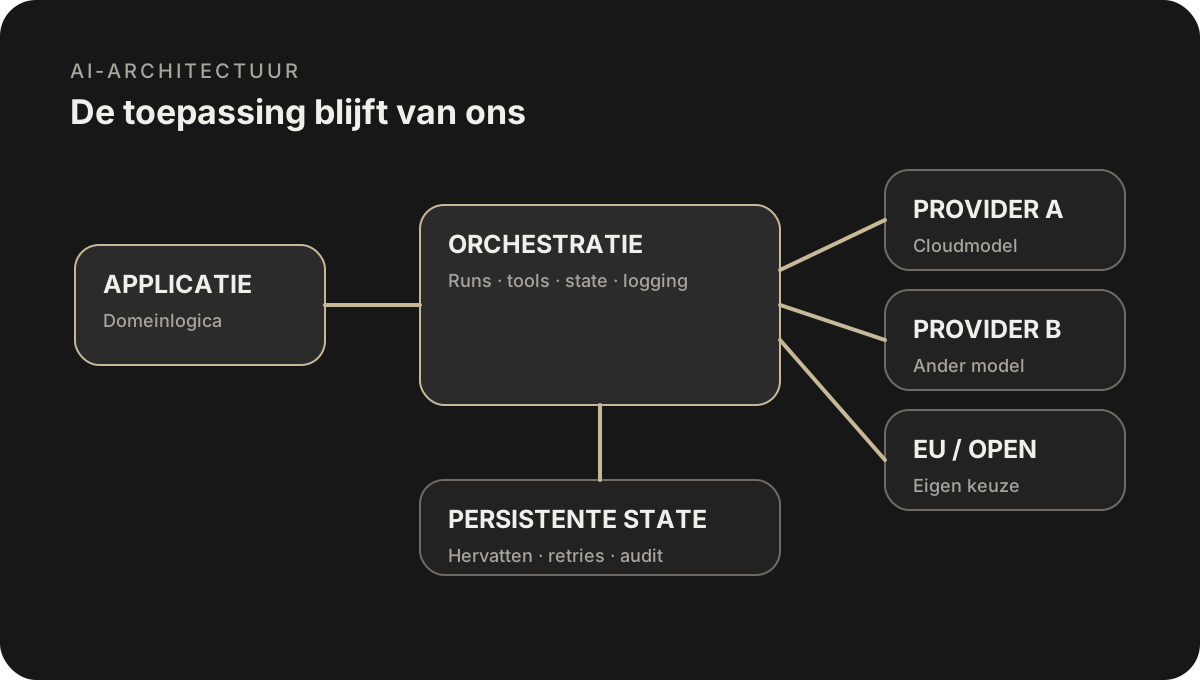
In zo'n architectuur onderscheiden we grofweg een paar verantwoordelijkheden:
- Domeinlogica bepaalt wat de toepassing probeert te bereiken.
- Orchestratie bewaakt stappen, context, tools en de voortgang van een run.
- Provider-adapters vertalen die opdracht naar de mogelijkheden van een specifiek platform of model.
- Opslag bewaart de toestand zodat een proces na een fout of herstart verder kan.
- Observability maakt zichtbaar welke stap wat heeft gedaan en waar iets misgaat.
Dat laatste wordt vaak onderschat. Zodra AI onderdeel wordt van een bedrijfskritisch proces wil je niet alleen weten dát iets fout ging. Je wilt kunnen terugvinden welk model is gebruikt, welke stap werd uitgevoerd, welke tool werd aangeroepen en welke bronnen onderdeel van de context waren.
Provider-onafhankelijk betekent niet: alles is hetzelfde
We proberen de verschillen tussen modellen nadrukkelijk niet weg te abstraheren alsof ieder model exact dezelfde mogelijkheden heeft.
Dat zou leiden tot de kleinste gemene deler.
Het ene model is sterk in tool use. Een ander is goedkoper voor classificatie. Sommige providers ondersteunen ingebouwde file search of persistent agents. Andere geven juist veel meer controle over hosting of modelgewichten.
Een goede abstractielaag moet daarom ruimte houden voor capabilities.
De toepassing kan bijvoorbeeld aangeven dat een taak structured output of tool-calling nodig heeft. De runtime kan vervolgens bepalen welke beschikbare provider daarbij past.
Zo blijft keuzevrijheid bestaan zonder te doen alsof alle onderliggende techniek identiek is.
Waarom dit ook voor soevereine AI relevant is
Provider-onafhankelijkheid gaat niet alleen over prijs of prestaties.
Voor steeds meer organisaties spelen ook datalocatie, contractuele eisen en digitale soevereiniteit een rol.
Een architectuur die alleen werkt zolang één Amerikaanse hyperscaler precies dezelfde diensten blijft aanbieden, beperkt je mogelijkheden wanneer een klant andere eisen stelt.
Door de toepassing en de AI-runtime uit elkaar te trekken ontstaat ruimte voor meerdere scenario's: cloudmodellen, Europese aanbieders of open-weight modellen op infrastructuur die de organisatie zelf kiest.
Dat betekent niet dat migreren altijd één druk op de knop wordt. De kwaliteit en mogelijkheden van modellen blijven verschillen.
Maar het maakt de keuze technisch mogelijk.
En dat is een belangrijk verschil.
Hervatbare AI-processen
Een ander onderdeel waar we veel aandacht aan besteden is de levensduur van een AI-run.
Niet ieder AI-proces is binnen een paar seconden klaar. Denk aan documentanalyse, een reeks controles of een agent die meerdere externe bronnen moet gebruiken.
Zo'n proces moet niet verloren gaan omdat een webserver herstart of een externe API tijdelijk niet beschikbaar is.
Daarom behandelen we langere AI-workflows steeds meer zoals andere gedistribueerde processen: met opgeslagen toestand, duidelijke stappen, retries en de mogelijkheid om verder te gaan waar het proces was gebleven.
AI wordt daarmee minder een bijzondere uitzondering in de architectuur en meer een normale technische bouwsteen.
Vrijheid om later een betere keuze te maken
Het doel van deze aanpak is niet om iedere week van provider te wisselen.
Het doel is dat we over twee jaar nog steeds een keuze hébben.
Dat vinden we belangrijk bij software die bedoeld is om langer mee te gaan dan de huidige AI-hypecyclus.