
Een van de inzichten die tijdens de ontwikkeling van MAIVA steeds duidelijker werd, is dat kennis vinden en kennis beheersen twee verschillende problemen zijn.
Stel dat een organisatie honderden documenten, procedures, handleidingen en vakinhoudelijke stukken heeft.
Met moderne AI kunnen we daar een assistent bovenop zetten. Een medewerker stelt een vraag en krijgt binnen een paar seconden een antwoord op basis van relevante bronnen.
Dat kan enorm veel zoektijd besparen.
Maar daarna weet die medewerker nog niet automatisch hoe het onderwerp in elkaar zit.
En dat verschil heeft steeds meer invloed op hoe we MAIVA ontwerpen.
Drie momenten waarop kennis nodig is
We zien grofweg drie situaties.
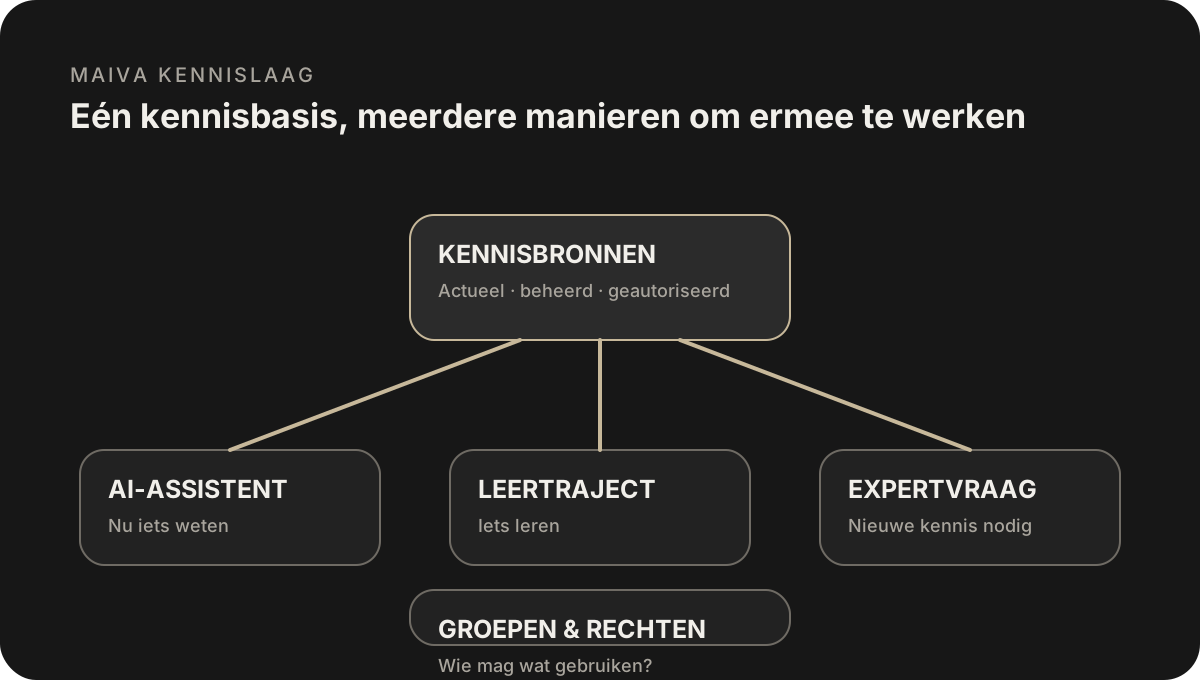
1. Ik moet nu iets weten
Een medewerker zit midden in een taak en zoekt één concreet antwoord.
Welke stap volgt na deze status? Welke regel geldt voor deze situatie? Waar staat het juiste formulier? Wat bedoelen we intern met deze term?
Daar past een AI-assistent goed bij. De gebruiker wil geen cursus volgen, maar direct verder kunnen.
2. Ik moet dit onderwerp leren
Een nieuwe medewerker moet een werkwijze begrijpen. Een professional moet nieuwe regelgeving doorgronden. Een externe deelnemer moet een methodiek leren toepassen.
Daar is één antwoord niet genoeg.
De kennis moet worden opgebouwd, in een logische volgorde, met vragen en momenten waarop iemand zelf moet nadenken.
Daarvoor gebruiken we leertrajecten.
3. Ik loop vast op een specifieke situatie
Soms past een vraag niet netjes in een bestaande uitleg of bron.
Dan wil je misschien een expertvraag kunnen stellen, extra context toevoegen of zichtbaar maken dat hier nieuwe kennis nodig is.
Juist dat soort vragen is interessant, omdat ze laten zien waar de kennisbasis nog gaten heeft.
Eén kennisbasis, meerdere toepassingen
Als je die situaties los van elkaar oplost, ontstaan al snel aparte systemen.
Een LMS voor leren. Een chatbot voor vragen. Een documentenbibliotheek voor bronnen. E-mail voor expertvragen.
Het gevolg is dat dezelfde kennis op meerdere plekken moet worden onderhouden.
Met MAIVA proberen we juist de kennislaag centraal te houden.
Kennisbronnen kunnen aan onderwerpen worden gekoppeld. Op basis daarvan kunnen verschillende AI-assistenten bestaan met hun eigen instructies en toegangsrechten. Leertrajecten kunnen dezelfde inhoud gebruiken om iemand stap voor stap door een onderwerp te leiden.
Groepen en rollen bepalen vervolgens wie welke onderdelen mag zien of gebruiken.
Dat maakt de kennis herbruikbaar zonder dat iedere toepassing exact hetzelfde hoeft te zijn.
Toegang is onderdeel van kennisbeheer
Niet iedere bron hoort voor iedereen beschikbaar te zijn.
Een organisatie kan interne procedures hebben, klantgebonden informatie, materiaal voor externe deelnemers of kennis die alleen experts mogen beheren.
Daarom is autorisatie geen technisch detail dat we pas aan het einde toevoegen.
De assistent moet bij ieder antwoord alleen kunnen werken met bronnen die binnen de context van die gebruiker zijn toegestaan.
Hetzelfde geldt voor leertrajecten en andere toepassingen rond die kennis.
Dat wordt belangrijker naarmate AI gemakkelijker informatie uit meerdere bronnen tegelijk kan combineren.
De kwaliteit van het antwoord begint vóór het model
Bij AI-systemen gaat veel aandacht naar de keuze van het model.
Logisch, want modellen verschillen sterk in kwaliteit en mogelijkheden.
Maar bij organisatiekennis ligt een groot deel van de kwaliteit ergens anders.
Zijn de bronnen actueel?
Is duidelijk welke bron leidend is?
Kan het systeem relevante passages goed terugvinden?
Krijgt een gebruiker alleen informatie waarvoor hij rechten heeft?
Kan iemand zien waar een antwoord vandaan komt?
Een groter model lost een slechte kennisbasis niet automatisch op.
Daarom zien we kennisbeheer, retrieval en AI steeds minder als losse onderwerpen.
Ze horen bij hetzelfde productontwerp.
Leren levert ook nieuwe kennis op
Interessant is dat leertrajecten niet alleen kennis verspreiden.
Ze kunnen ook zichtbaar maken waar mensen moeite mee hebben.
Welke vragen worden vaak verkeerd beantwoord? Waar vragen deelnemers extra uitleg? Welke expertvragen blijven terugkomen? Welke bron blijkt in de praktijk onduidelijk?
Dat geeft een organisatie informatie over de kwaliteit van haar eigen kennis.
Daarmee ontstaat een cyclus:
kennis vastleggen, beschikbaar maken, gebruiken, leren waar onduidelijkheid zit en de bron verbeteren.
Van documenten naar actieve kennis
Dat is uiteindelijk de grotere gedachte achter MAIVA.
Een document is waardevol, maar pas echt nuttig wanneer de inhoud op het juiste moment bij de juiste persoon komt.
Soms als kort antwoord.
Soms als leerstap.
Soms als bron bij een beslissing.
En soms als aanleiding voor een nieuwe vraag aan een expert.
Kennis beschikbaar maken is dus een goed begin.
Maar het interessante werk begint bij de vraag hoe je ervoor zorgt dat die kennis ook wordt begrepen en gebruikt.